过去十天,三家模型厂商几乎同时做了一件事:把「AI 生成内容带标记」从公告变成了默认行为。
10 月 5 日,OpenAI 发布文本水印 textGrain,欧盟地区的 ChatGPT 与 Codex 默认启用,全球 API 客户可以按项目自行开启。11 月 3 日,Anthropic 开始给 Claude Mythos 5、Opus 4.7、Sonnet 4.6 补装文本水印,11 月 16 日再补 Opus 4.6、Opus 4.5、Sonnet 4.5 与 Haiku 4.5,Amazon Bedrock 上的部署晚几天。11 月 7 日,xAI 的 Grok API 对 7 个模型默认加水印,开发者可以在响应头里看到 x-watermark。
这不是行业自律忽然变强了。欧盟《人工智能法案》第 50 条第 2 款要求,生成合成音频、图像、视频或文本的系统,必须让输出「以机器可读的格式标记,并可被识别为人工生成或篡改」。这条义务自 2026 年 8 月 2 日起适用;对于 8 月 2 日之前已经上市的生成式系统,法案第 111 条给了到 2026 年 12 月 2 日的补课期。7 月生效的 (EU) 2026/1744 只推迟了高风险系统的义务(附件三到 2027 年 12 月 2 日、附件一到 2028 年 8 月 2 日),透明度与标记这一条没有推迟。
对做企业站、独立站和短视频内容的团队来说,这件事的影响不在「模型会不会被罚款」,而在两处更具体的地方:一是你的内容流水线会不会把厂商加上的标记洗掉;二是你自己对外发布内容时,披露义务落在谁头上。这篇文章把三类标记拆开,讲清各自能证明什么、在哪里失效,再给一套两周能跑起来的最小接法。文末列出引用口径,也列出没有采用的数字。
一、三种标记,加一层自己的台账
现在说「打标」,至少指三件不同的事,再加一件企业自己的事。
文本内水印是生成时留在文字里的统计信号。它不改字、不加隐藏字符,靠选词概率的轻微偏移形成可检测的模式,复制粘贴会跟着走。它能回答的问题是「这段文字有没有经过某个模型」,回答不了「哪几句是人写的」。
文件级内容凭证是随文件走的签名清单,代表标准是 C2PA(Content Credentials)。它记录谁签发、何时生成、用了什么工具、经过哪些编辑,并用哈希把清单与文件字节绑定。它能回答「这份清单是否与这些字节匹配、签名是否来自某个证书」,回答不了「画面里的人是不是真的」。
可见标识是给人看的:平台在内容旁挂的「AI 生成」标签、欧盟发布的统一图标、网站图注和视频描述里的说明。它不依赖元数据,截图也带得走,但需要人来判断标得对不对。
业务台账是企业自己的记录:哪条素材、在哪个环节、用了哪个模型和版本、提示词摘要是什么、谁做的最后修改、发到了哪些渠道。它不对外,但在标记丢失、误标申诉、客户追责时,是把链路还原出来的那层东西。
| 层 | 载体 | 能证明什么 | 典型失效方式 | 适合场景 |
|---|---|---|---|---|
| 文本水印 | 文字本身 | 这段文字是否经过某模型处理 | 改写、翻译、短文本、代码、非默认采样参数 | 长文、报告、公开声明 |
| C2PA 凭证 | 文件元数据 | 清单与字节是否匹配、签发者是谁 | 截图、另存、转码、平台剥离元数据 | 产品图、视频、对外交付文件 |
| 可见标识 | 画面或页面 | 读者是否被明确告知 | 漏标、错标、标了但不够醒目 | 所有对外发布渠道 |
| 业务台账 | 企业自有系统 | 这条素材的生成与发布链路 | 字段缺失、事后补录、人员离职断档 | 内部追溯、客户答疑、申诉 |
四层的关系是互补,不是替代。文本水印负责「内容自己带着信号走」,C2PA 负责「文件带着可验证的来路」,可见标识负责「让读者一眼知道」,台账负责「信号都丢了以后还能查」。只做其中一层,都会在某个环节断掉。
二、12 月 2 日这个日期,管的是哪一批系统
先把时间线摆清楚,避免把「延期」误读成「放松」。
2026 年 8 月 2 日,第 50 条的透明度义务开始适用。此后新上市的生成式模型,出厂就该带标记——Anthropic 的说法是 8 月 2 日之后发布的模型「第一天就有」,这也是为什么它现在做的是「给旧模型补装」。2026 年 12 月 2 日,是给 8 月 2 日之前已上市系统的补课截止日。Anthropic 帮助页写明,所有旧模型会在 12 月 2 日前覆盖完;xAI 选在 11 月 7 日,也是赶这个节点。
欧盟在 7 月生效的 (EU) 2026/1744 里,改的是高风险系统的合格评定时间:附件三所列的独立高风险系统推到 2027 年 12 月 2 日,嵌入受管制产品的高风险 AI 推到 2028 年 8 月 2 日。禁止性实践、通用模型义务、透明度与标记义务都没有顺延。把「高风险延期」当成「标记也可以等」,是这一轮最常见的误读。
配套的《AI 生成内容透明度行为准则》是一条可走的路:签署方按准则实施标记与标签,作为证明合规的公认路径,但不是「签了就自动合规」。2026 年 9 月 30 日,90 多家签署方成立了两个工作组,一个管标记与检测,一个管标签;欧盟委员会也发布了用于标识 AI 生成内容的统一图标。准则里有一条对企业很实际的界定:短于 200 个 token(英文约 150 个词)的输出和代码片段,不要求加水印——不是不想管,而是这个长度上检测本来就不稳定。
责任落在两侧。提供生成能力的一方要确保输出可被机器识别;使用这些能力对外发布内容的一方,在深度合成内容和涉及公共利益的信息上,要作出披露。把第三方模型包装成自己品牌的产品对外提供,通常会被按提供者对待,不能只在上游合同里写一句「合规由模型方负责」就结束。
三、文本水印:能跟着文字走,但经不起改写
文本水印的原理不复杂。模型生成每个词时,本来是在一组候选里按概率抽样;水印系统用一把密钥,把候选词分成若干组,在保持整体分布不变的前提下,让某一组被选中的概率略高一点。几百个词累积下来,就形成了统计上的偏向。检测器拿同一把密钥去算,看这段文字符合秘密模式的频率是否明显高于随机预期。
Anthropic 用的是 Google DeepMind 的 SynthID-Text;OpenAI 自研的 textGrain 走的是「熵校准 + 最优传输」的路线,官方称不改字符、不加 token、不影响计费与请求格式;xAI 的文档只说是「对 token 选择施加细微影响」,检测结果分「已加水印 / 未加水印 / 不确定」三种。
效果数据要看清楚适用条件。OpenAI 公布的测试是 1% 目标误报率下:400 token 的段落检出率约 92%–95%,200 token 约 80%。换成同义词会明显削弱信号:400 token 文本替换 10% 的词,检出率从约 92% 降到 66%;替换 25%,只剩 17%。数学推导、代码注释这类可选表达很少的内容,检出率更低。多语言也不齐:OpenAI 用 500 条英文提示翻译成 23 种欧盟官方语言测试,同样误报率下,检出率从罗马尼亚语的 42.2% 到西班牙语的 69.0%。
还有两个工程细节容易被忽略。其一,Anthropic 的发布说明写明,Sonnet 4.6 在把 temperature / top_p / top_k 设为非默认值时,可能不落水印;The Decoder 的核对也发现,部分旧模型存在类似的绕过方式。其二,短文本和代码片段本来就在准则的豁免范围内,商品标题、meta description、客服快捷话术、短视频字幕,基本都在水印的弱信号区。
所以文本水印的定位应该是「线索」,不是「证据」。它能帮你判断一篇长文是否经过某模型处理,但不能告诉你其中多少是人写的,也不能用来认定版权归属。对企业内容团队,真正要改的不是「怎么检测」,而是「长文与短文案分开处理」:长文可以依赖模型侧标记,短文案必须靠自己的可见披露与台账。
四、C2PA:能证明清单没被改,不能证明内容是真的
C2PA 的技术结构可以拆成三层:断言(assertions)记录发生了什么,比如用了哪个模型、做过哪些编辑、是否由 AI 生成;声明(claim)把一组断言组织起来,并算出与文件字节绑定的哈希;签名用签发方的私钥对声明做 COSE 签名,证书走 X.509。清单随文件走,读取方可以验证签名、比对哈希,再看签发证书是否在可信列表里。
绑定方式有两种。硬绑定把哈希写进清单,文件改动一个字节就会校验失败;软绑定用水印或指纹关联外置清单,适合不方便改文件结构的格式。当前规范版本是 2.4,支持把「AI 生成」「AI 处理」写成明确的断言,也支持链式记录——相机拍一张、设计软件改一次、生成工具再处理一次,每一步都追加自己的清单,上一版作为原料被引用。
C2PA 的强项是「可验证」,弱点也同样明确:它验证的是清单与字节的对应关系,不是内容本身的真实性。一张真实照片可以被配上伪造的拍摄信息,一段合成视频也可以拥有完全合法的签名链。验证通过只说明「这份清单没有被改、签名来自这个证书」,不说明「画面里的人真的在场」。
更常见的失败发生在传播环节。截图会丢掉全部元数据;图片被重新保存、转成 WebP、经过 CDN 的缩放与裁剪,清单可能不再匹配;不少社交平台在上传时会重写文件,凭证随之消失;视频转码、剪辑、加字幕也会打断哈希。C2PA 不是「打一次就永久有效」,它要求发布链路每一步都使用能保留并追加清单的工具;一旦中间有人用截图代替原文件,链就断了。
五、可见标识:最容易做,也最容易标错
可见标识是给人看的,所以它的第一要求不是技术,而是准确。欧盟发布的统一图标用于在内容首次呈现时告知读者;平台侧的自动标签,则越来越依赖 C2PA 凭证与厂商水印——凭证在,标签就可能自动出现;凭证被剥离,标签也就不会出现。这也是为什么「只在平台上打标签」不够稳:标签的触发条件不在你手里。
企业自己的页面要补三处。图片在图注里写清生成方式,比如「示意图,由 AI 生成」「产品渲染图,经 AI 辅助修图」,不要笼统写成「AI 图片」;视频在描述或片头用一句话说明哪些片段是生成的;长文如果整篇由模型起草,在文末说明起草与人工编辑的分工。B2B 场景里,白皮书的数据图、案例页的现场图、产品页的渲染图,是最容易被误认为真实素材的三类,优先处理。
反过来,也不要把所有用过 AI 辅助的内容都标成「AI 生成」。用模型改过错别字、调过语气的稿件,标成「全文由 AI 生成」同样是错误信息,会让读者对整站内容失去信任。判断标准可以简单一点:读者看到这段内容时,会不会对「它是怎么来的」产生实质误解?会,就披露;不会,就不必加。
六、内容流水线怎么接:四个环节,两周能跑起来
真正要改的不是某个按钮,而是四个交接点。
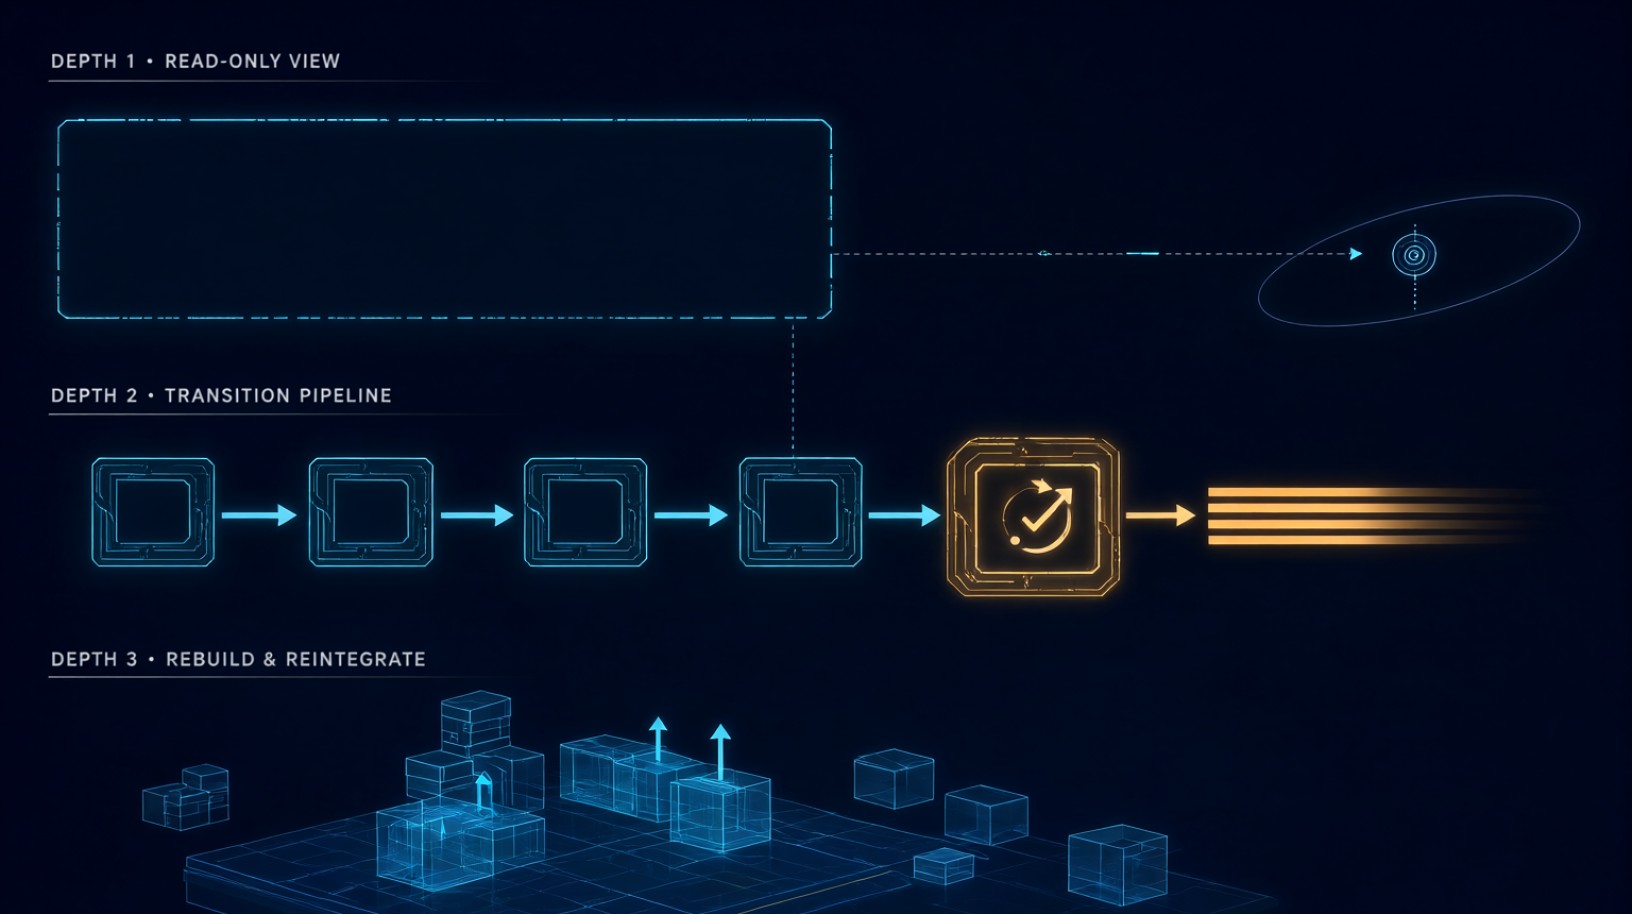
生成入口。素材一生成就记四件事:模型与版本、生成时间、提示词摘要、操作人。不要等发布前再补,事后补录的台账在追责时没有说服力。图片和视频尽量保留原始文件,后续所有加工都从原件派生,而不是从截图派生。
加工链。能用支持 C2PA 的工具就用,导出时选择保留元数据;必须裁切或压缩时,保留原件与外置清单,记录「哪一步产生了哪个派生文件」。这里最常见的坑是设计稿截图:视觉上没差别,凭证却全丢了。
发布通道。不同通道对元数据的处理差别很大,发布后要回验,而不是发完就算。下面这张矩阵可以直接当检查表用,具体保留情况以各平台当期行为为准,建议每季度抽一批重测。
| 通道 | 凭证保留预期 | 主要原因 | 兜底做法 |
|---|---|---|---|
| 自有独立站 | 较高,取决于图片处理链 | CDN 缩放、格式转换、压缩插件可能重写文件 | 原图与派生图分开存,页面加图注 |
| 邮件与附件 | 较高 | 文件通常原样传输 | 正文写明素材来源与生成方式 |
| 社交平台 | 较低 | 上传时重写文件、二次压缩 | 文案内可见披露,保留原件与台账 |
| 短视频平台 | 较低 | 转码、剪辑、平台压缩 | 片头或描述标注,台账记录生成片段 |
| 截图与转发 | 无 | 像素被重绘,元数据不随截图走 | 把截图视为新素材,重新标注 |
撤回与更正。发现误标或漏标,要能在 48 小时内定位到具体素材并替换。这要求每条对外素材都有稳定的资产 ID,页面、社媒、邮件里的引用都指向这个 ID,而不是指向一个文件名。没有这层映射,撤回就会变成「挨个平台找图」。
两周的最小改造可以按下面的顺序排。
| 步骤 | 动作 | 产出物 | 工期 |
|---|---|---|---|
| 1 | 盘点三类资产与发布通道,抽样回验现有元数据 | 资产清单、通道矩阵 | 2–3 天 |
| 2 | 给生成环节加四个字段,接入资产 ID | 生成记录表、字段规范 | 3–4 天 |
| 3 | 图片与视频接入 C2PA 签名,导出保留元数据 | 签名流程、验证脚本 | 3–5 天 |
| 4 | 补齐页面与视频的可见披露,建立撤回流程 | 披露模板、撤回 SLA | 2–3 天 |
技术侧不必从零写。C2PA 有开源的命令行工具与 SDK,可以完成签名、读取与验证;文本水印的检测接口目前多不对外开放,Anthropic 的检测 API 处于私密预览,只对监管机构、媒体、事实核查、研究人员和确有自身合规义务的企业开放,xAI 与 OpenAI 也采用申请制。企业能自己做的是「发布后回验」:检查文件里有没有可读的清单、签名与字节是否匹配、平台页面上有没有出现预期的标签。
七、验收:五个能按周记录的指标
标记这件事很容易做成一次性项目,然后慢慢失效。验收指标要能周度记录,且不依赖厂商的检测接口。
- 标记覆盖率:本周新生成并对外发布的素材中,带有签名清单或明确可见披露的比例。按图片、视频、长文、短文案四类分别统计,短文案单列,因为它的技术标记本来就不稳定。
- 通道保留率:发布后从每个通道取回文件,验证清单仍然可读的比例。这个数字按平台看比看总数有用,掉得最厉害的那个平台就是下一个要补披露的地方。
- 台账完整率:模型、版本、时间、操作人四个字段齐全的素材占比。低于 95% 时先查流程,不要先怪工具。
- 撤回定位时长:从发现误标到定位到资产 ID 的中位时长。目标是当天定位、48 小时内替换。
- 误标更正时长:客户或平台指出标注不准确,到完成更正的时长。这个指标反映的是审核环节,而不是技术环节。
八、边界与成本:标记不是真实性证明
三条边界要先说清。第一,标记不等于真实性:带签名的内容可以是合成的,没有签名的内容也可能是真的。第二,检测不到不等于人工写的:短文本、代码、改写、翻译、格式转换都会让信号消失,OpenAI 与 Anthropic 的帮助页都写明了这一点。第三,标记不能替代合同、授权与版权登记,它只能作为链路核对的线索。
成本主要不在软件。签名需要证书与私钥管理,私钥泄露比不签名更糟;视频与图片的原始文件会显著增加存储;流程改造要占设计和运营的人天,最大的成本是「每次加工都从原件派生」这个习惯。小团队可以从开源工具起步,先把资产 ID 与生成记录做起来,再决定是否自建签名服务。
还有一个常被忽略的成本:错误的标签会带来信任损失。把人工撰写的深度稿标成「AI 生成」,比不标更伤;把合成图当现场图发布,事后更正也补不回来。披露的原则是「准确、具体、不夸大」,而不是「一律加一句 AI」。
本文基于公开法规与厂商文档整理,不构成法律意见。具体产品是否落入第 50 条、以什么身份承担责任,需要结合投放市场的时间、品牌归属与使用场景单独判断。
常见问题
我们只是用 AI 写营销文案,也要打标吗?
要区分两件事。模型厂商的标记义务由他们承担,你不需要替他们加水印;但你对外发布内容时的披露义务在自己的场景里。涉及深度合成画面、或面向公众传播的 AI 生成文本,应按用途披露。普通的产品描述、内部草稿,重点是把生成记录留好,不必一律加「AI 生成」。
检测到水印,能证明这段文字是我们用 AI 写的吗?
不能。检测到标记只说明内容在某处经过该模型处理,可能是起草,也可能是校对、翻译、摘要。反过来,没有检测到也不代表是人写的。把它当作线索,不要当作结论。
图片上传到平台后凭证丢了,怎么办?
先确认丢在哪一步:是导出时没保留,还是平台重写了文件。导出环节可以修,平台行为改不了。平台会剥元数据的,就用页面可见披露加台账兜底,并在通道矩阵里把该平台标成「需人工披露」。
自己签发 C2PA 需要什么?
需要一套签名证书与私钥管理流程,以及能写入清单的工具链。证书可以由公共 CA 或自有信任体系签发,读取方是否信任取决于其信任列表。起步阶段可以先用工具做「保留厂商清单、追加自己的编辑记录」,不必一上来就自建证书体系。
12 月 2 日之后,旧模型的输出怎么办?
厂商侧在补:Anthropic 计划在 12 月 2 日前覆盖全部旧模型,xAI 从 11 月 7 日起默认开启,OpenAI 对欧盟地区默认启用。企业侧要做的是确认自己调用的模型与区域是否在覆盖范围内,并在采购条款里写清水印开关、检测接口与披露责任,避免上线后才发现某个区域或某个云厂商的部署还没跟上。
附:口径与来源
- 欧盟《人工智能法案》Regulation (EU) 2024/1689 第 50 条第 2 款:生成合成音频、图像、视频或文本的系统,须确保输出以机器可读格式标记、可被识别为人工生成或篡改;该义务自 2026 年 8 月 2 日适用。
- 同一法案第 111 条:2026 年 8 月 2 日前已投放市场的生成式系统,须在 2026 年 12 月 2 日前满足第 50 条第 2 款。
- Regulation (EU) 2026/1744(Digital Omnibus 的 AI 部分,2026 年 7 月生效):高风险系统义务推迟至 2027 年 12 月 2 日(附件三)与 2028 年 8 月 2 日(附件一);透明度与标记义务未顺延。
- 欧盟委员会《AI 生成内容透明度行为准则》及其配套页面:2026 年 9 月 30 日,90 多家签署方成立「标记与检测」「标签」两个工作组;欧盟发布用于标识 AI 生成内容的统一图标;准则对短于 200 token 的输出与代码片段不要求加水印。
- Anthropic 帮助页《How Claude marks AI-generated content》与 2026 年 8 月公告:文本水印基于 SynthID-Text;PNG/JPEG 等文件附加 C2PA 内容凭证;8 月 2 日后发布的模型出厂带标记,旧模型在 12 月 2 日前补齐;检测 API 处于私密预览。
- OpenAI 帮助页《Provenance signals in OpenAI-generated content》与 2026 年 10 月 5 日 textGrain 发布说明:欧盟地区 ChatGPT 与 Codex 默认启用,全球 API 由客户选择开启;1% 目标误报率下,400 token 段落检出率约 92%–95%,200 token 约 80%;替换 10% 同义词降至约 66%,替换 25% 降至 17%;23 种欧盟官方语言检出率 42.2%–69.0%。
- xAI 开发者文档「Output Watermarking」(2026 年 10 月 31 日更新):自 2026 年 11 月 7 日起,7 个 Grok 模型 API 输出默认加水印,响应头
x-watermark标识;检测结果分「已加水印 / 未加水印 / 不确定」,检测接口需申请。 - C2PA 技术规范 2.4:清单由断言、声明与签名构成,硬绑定使用哈希、软绑定使用指纹或水印,签名使用 X.509 证书与 COSE;支持 AI 生成与处理断言。
- 未采用:中文媒体转引的「某厂商水印准确率 99%」「企业 AI 内容合规成本平均多少」等无法回到英文一手文档的数字,本文未引用;文中出现的检出率均标注了测试条件与来源,不能直接外推到中文短文案场景。
- 本文不构成法律意见;不承诺任何平台的标签呈现、检测结果或收录效果,具体实施需按企业所在法域、投放市场时间与内容类型单独评估。